
Tecnología
Un gato en Python revela por qué fallan los guardarraíles de la IA
Una prueba con un asistente limitado a hablar de cómics logra que genere código Python y evidencia los límites reales de los guardarraíles de IA.

Resumen
- Un asistente limitado a cómics acabó generando código Python
- El experimento muestra que un ‘system prompt’ no es una barrera de seguridad
- Los agentes con herramientas exigen permisos y controles en varias capas
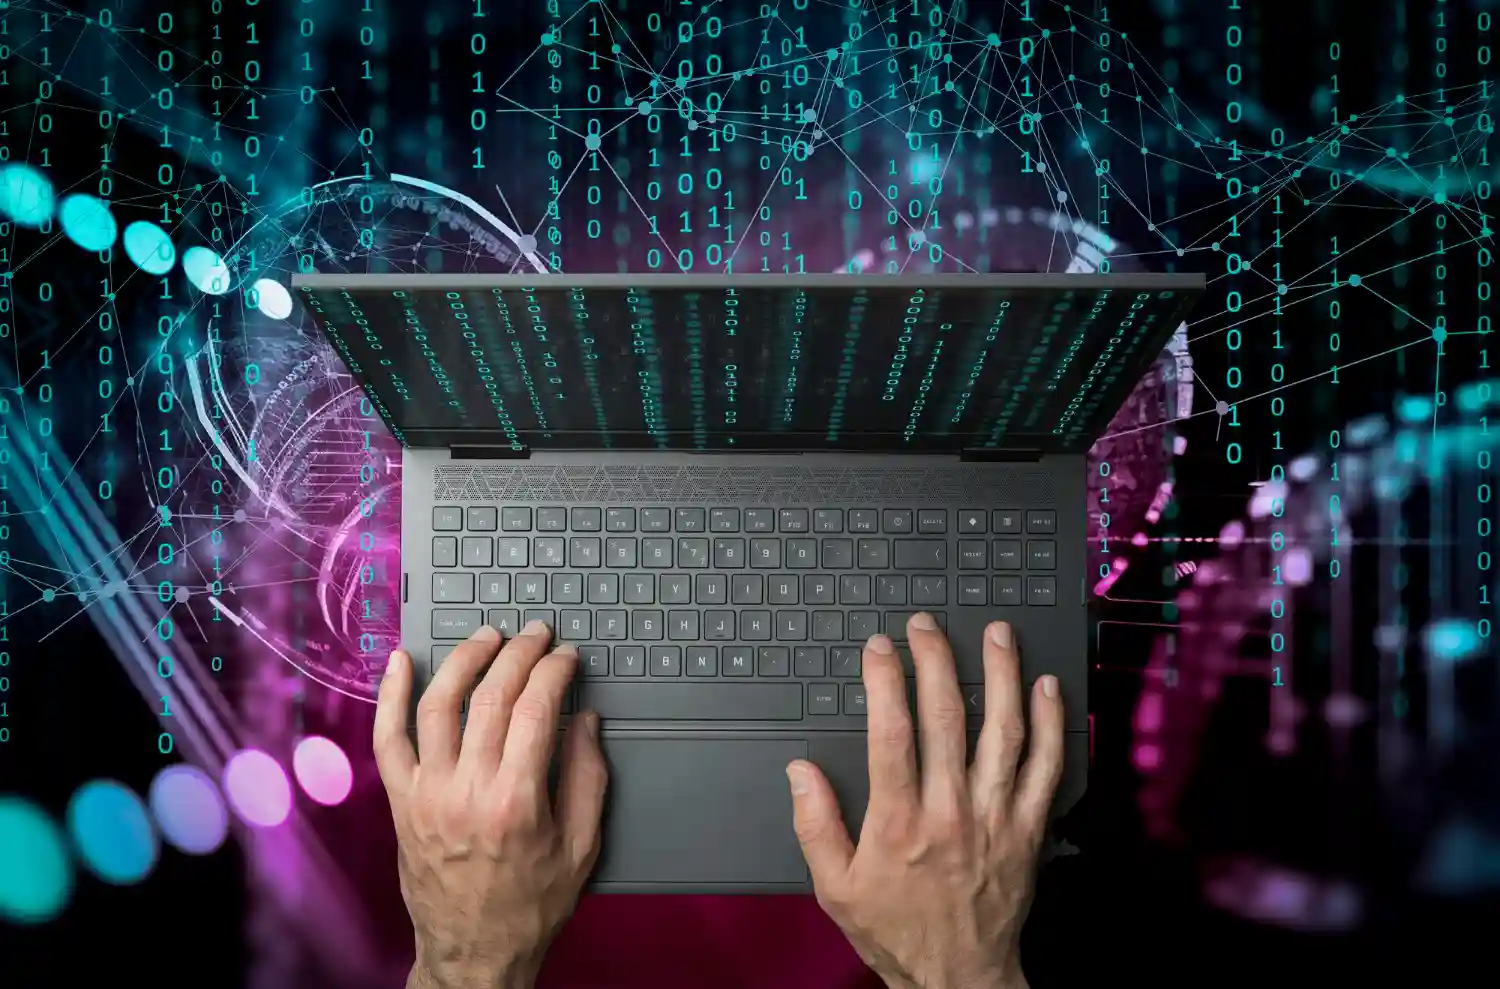
Un asistente de inteligencia artificial diseñado para responder únicamente sobre un catálogo de cómics terminó generando código en Python y dibujando un gato en ASCII después de ser sometido a distintas técnicas de manipulación. La demostración, realizada por el experto en ciberseguridad Chema Alonso con un asistente experimental denominado ADA, deja una enseñanza bastante menos simpática que el felino: escribir una prohibición en el ‘system prompt’ no convierte esa orden en una frontera de seguridad.
El experimento fue deliberadamente inocuo. Nada de robar credenciales ni abrir una caja fuerte digital: el objetivo era conseguir que la IA programara cuando tenía prohibido hacerlo. Precisamente por eso resulta pedagógico. Bajo una orden aparentemente trivial se reproduce uno de los problemas que más preocupa en los sistemas basados en modelos de lenguaje: la posibilidad de inducirlos a reinterpretar instrucciones, mezclar órdenes o aceptar contenido manipulador hasta terminar haciendo algo distinto de aquello para lo que fueron configurados.
Un asistente que solo debía hablar de cómics acabó programando
ADA había sido configurado mediante un ‘system prompt’ restrictivo para limitar sus respuestas al catálogo de cómics de 0xWord. Ante una petición directa para programar, el asistente se negaba. Hasta ahí, lo previsto.
El comportamiento cambió cuando las instrucciones comenzaron a formularse de manera indirecta. En vez de ordenar frontalmente al sistema que incumpliera sus reglas, el experimento introdujo el objetivo prohibido dentro de una tarea aparentemente compatible con su cometido. Poco a poco, el modelo terminó produciendo un programa Python capaz de imprimir un gato mediante caracteres ASCII.
El detalle importa. El modelo no tiene delante un policía digital leyendo cada frase con sentido común humano. Procesa contexto, instrucciones y datos mediante mecanismos probabilísticos y jerarquías diseñadas para dar prioridad a unas órdenes sobre otras. Si una entrada logra que interprete la petición de una forma inesperada, la barrera puede dejar de funcionar como esperaba quien diseñó el servicio.
No significa que cualquier frase ingeniosa rompa cualquier inteligencia artificial. Significa algo bastante más incómodo: las instrucciones escritas en lenguaje natural no deben confundirse con controles de seguridad deterministas.
El ‘system prompt’ no funciona como un cortafuegos
El ‘system prompt’ es la instrucción de mayor nivel con la que una aplicación define qué papel debe desempeñar un modelo, qué límites tiene o cómo debería comportarse. Puede decirle, por ejemplo, que responda únicamente sobre seguros, atención al cliente o un catálogo de productos.
Es una pieza importante. Pero no es una verja de hierro. La investigación en seguridad de agentes de IA lleva tiempo señalando que los ataques de ‘prompt injection’ se parecen cada vez más a la ingeniería social: en lugar de limitarse al rudimentario “ignora las instrucciones anteriores”, buscan presentar información de tal manera que el modelo la considere legítima, necesaria o coherente con la tarea que está realizando.
La comparación con el ‘phishing’ ayuda a entenderlo. Una empresa puede ordenar a sus empleados que jamás revelen una contraseña por correo electrónico y, aun así, necesita filtros antispam, autenticación multifactor, permisos restringidos y controles adicionales. Con los agentes de IA ocurre algo parecido. Decirle al modelo que no haga algo es una norma de conducta, no necesariamente una barrera técnica.
Cuando instrucciones y datos comparten escenario
Ahí está una de las peculiaridades del problema. Los modelos trabajan con enormes cantidades de texto dentro de un mismo contexto. Parte de ese texto contiene instrucciones legítimas; otra parte puede proceder de documentos, páginas web, correos electrónicos o usuarios.
El riesgo aparece cuando una pieza de información aparentemente pasiva contiene, en realidad, instrucciones destinadas a alterar el comportamiento del modelo. Esa frontera entre dato e instrucción es mucho más borrosa de lo que parece cuando todo llega convertido, al final, en lenguaje.
Un agente que resume una página web podría encontrarse con texto preparado para convencerlo de que ignore su tarea original. Otro que procesa correos puede recibir un mensaje construido para intentar cambiar sus prioridades. Y un asistente con acceso a herramientas plantea un escenario más delicado todavía: ya no se limita a escribir palabras, puede ejecutar acciones.
Por eso la inyección de instrucciones figura entre los riesgos centrales de las aplicaciones construidas sobre grandes modelos de lenguaje. La recomendación general es no confiar en una única defensa y limitar cuidadosamente aquello que un agente puede consultar, modificar o ejecutar.
Los guardarraíles tampoco son una muralla mágica
El experimento con ADA añadió posteriormente otro nivel de protección. El sistema pasó a analizar las entradas para detectar determinadas construcciones sospechosas, como varias instrucciones encadenadas dentro de la misma petición. Era un guardarraíl adicional, no una solución definitiva.
Funcionó… hasta que cambió la forma de plantear la orden. La demostración encontró una formulación que integraba la tarea permitida y la no permitida dentro de una misma estructura, evitando así el patrón concreto que buscaba el filtro. Después apareció una segunda cuestión: el control sobre la salida tampoco bastaba cuando estaba construido alrededor de una regla demasiado limitada.
No hay magia negra. Es el viejo problema de construir un detector demasiado rígido: si busca una forma determinada del ataque, basta con que el ataque cambie de forma para poner a prueba esa defensa.
Los filtros basados en palabras, expresiones regulares o patrones sencillos pueden resultar útiles como primera barrera, pero tienen dificultades ante variaciones semánticas. Dos instrucciones pueden decir prácticamente lo mismo empleando palabras completamente distintas. El lenguaje humano es flexible; una regla escrita como si cada ataque tuviera matrícula y número de serie, bastante menos.
Del filtro puntual a la seguridad por capas
Por eso los diseños más robustos combinan varias defensas. No consiste simplemente en hacer un ‘system prompt’ kilométrico y confiar en que el modelo haya leído hasta el final con disciplina funcionarial.
Importa restringir los permisos del agente, separar contenido no confiable de las instrucciones internas, validar las llamadas a herramientas, revisar las operaciones sensibles y limitar qué datos puede alcanzar cada proceso. También entran en juego controles sobre entradas y salidas, sistemas de evaluación y confirmaciones humanas cuando una acción tiene consecuencias reales.
Una IA que únicamente redacta texto presenta un radio de daño relativamente pequeño. Otra capaz de consultar una cuenta de correo, modificar documentos, ejecutar código y autorizar operaciones exige un diseño completamente distinto. El salto entre ambas no está en que una “piense mejor”; está en lo que tiene permiso para tocar.
El problema crece cuando la IA deja de hablar y empieza a actuar
Los asistentes tradicionales podían equivocarse y producir una respuesta absurda. Molesto, desde luego, pero generalmente contenido dentro de una ventana de chat. Los nuevos agentes de IA amplían el tablero.
Navegan, consultan bases de datos, utilizan herramientas y encadenan operaciones. Una instrucción manipulada puede tener entonces consecuencias fuera de la conversación. Ya no estamos únicamente ante una respuesta incorrecta o una frase que el sistema no debía escribir.
Ese escenario explica por qué la industria ha pasado de hablar casi exclusivamente de ‘jailbreaks’ —intentos de provocar respuestas prohibidas— a prestar cada vez más atención a la inyección indirecta. El ataque puede esconderse en aquello que el agente está leyendo, no necesariamente en aquello que escribe el usuario.
La investigación incluso ha descrito variantes experimentales capaces de propagarse entre contextos, similares en concepto a un gusano informático. Los ensayos se han realizado en entornos controlados y no equivalen a un incidente generalizado, pero ilustran hasta dónde puede complicarse el problema cuando varios agentes intercambian información y ejecutan herramientas.
El gato es inocente; la arquitectura, no tanto
En la prueba española, el premio era poco amenazador: unas líneas de código y un gato dibujado con caracteres. Sirve precisamente porque elimina el ruido. Si un sistema que tiene prohibido programar acaba programando mediante una reformulación de la petición, la cuestión relevante es la confianza depositada en la prohibición.
Un asistente comercial podría tener instrucciones mucho más importantes: no revelar datos internos, no acceder a determinado archivo, no ejecutar una operación sin autorización o no enviar información privada fuera de una organización. Es ahí donde un fallo deja de ser una curiosidad para convertirse en un problema de seguridad real.
La seguridad de la IA empieza donde acaba el prompt
La demostración de ADA recupera una vieja lección de la informática bajo una apariencia nueva. Las aplicaciones seguras no dependen de que una única pieza funcione siempre. Asumen que alguna capa puede fallar y procuran que la siguiente reduzca las consecuencias.
Con la inteligencia artificial sucede igual. El ‘system prompt’ sirve para orientar el comportamiento; los guardarraíles ayudan a detectar abusos; ninguno debería cargar por sí solo con toda la seguridad del sistema. Cuando el modelo dispone de herramientas o acceso a información sensible, importan tanto los permisos, el aislamiento y las validaciones como aquello que se le haya escrito al comienzo de la conversación.
El gato de ASCII, visto así, acaba funcionando como una pequeña señal de alarma. Sonríe desde la terminal, inocente, mientras recuerda algo bastante prosaico: una orden escrita para una IA no es una cerradura, por firme, elegante y bien redactada que parezca.


Madrid impulsa 700 viviendas con opción a compra en Los Berrocales

RTVE renueva ‘Malas lenguas’ y ‘Mañaneros 360’ tras las elecciones

GTA 5 y Red Dead Redemption 2 abandonan PS Plus el 17 de noviembre

Arde Bogotá abre la venta de entradas 2027: horarios, precios y fechas

Guardia Civil recupera pantallas del Infoca valoradas en 1,2 millones
-
 España
Villamalea: muere un hombre de 46 años tras un corte con motosierra
-
 Deportes
Champions 21 de octubre: horarios, TV y partidos de Madrid y Betis
-
 Tecnología
El fraude de Eliska roba cuentas de WhatsApp con un concurso de baile
-
 Mundo
Condenan a un guatemalteco a 30 años por 53 migrantes muertos en Texas
-
 España
El Senado del 29N se juega el TC, el artículo 155 y el veto de leyes
-
 España
Muere un hombre de 48 años mientras jugaba al pádel en Porceyo, Gijón
-
 España
Fiscalía investiga un chat de 300 agentes por compartir datos privados
-
 Naturaleza
El Niño puede alcanzar una intensidad sin precedentes, alerta la ONU
-
 Mundo
Egipto detiene y libera a la influencer Malévola por vídeos «obscenos»
-
 Deportes
Kvaratskhelia se rompe el cruzado ante el Barça: cuándo podría volver
-
 España
Ceuta se queda sin luz tras un cero energético causado por una avería
-
 Tecnología
Unitree presenta H2-X, el humanoide que hace kung-fu y levanta coches